Domain eyepatches.de kaufen?
Wir ziehen mit dem Projekt
eyepatches.de um.
Sind Sie am Kauf der Domain
eyepatches.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain eyepatches.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
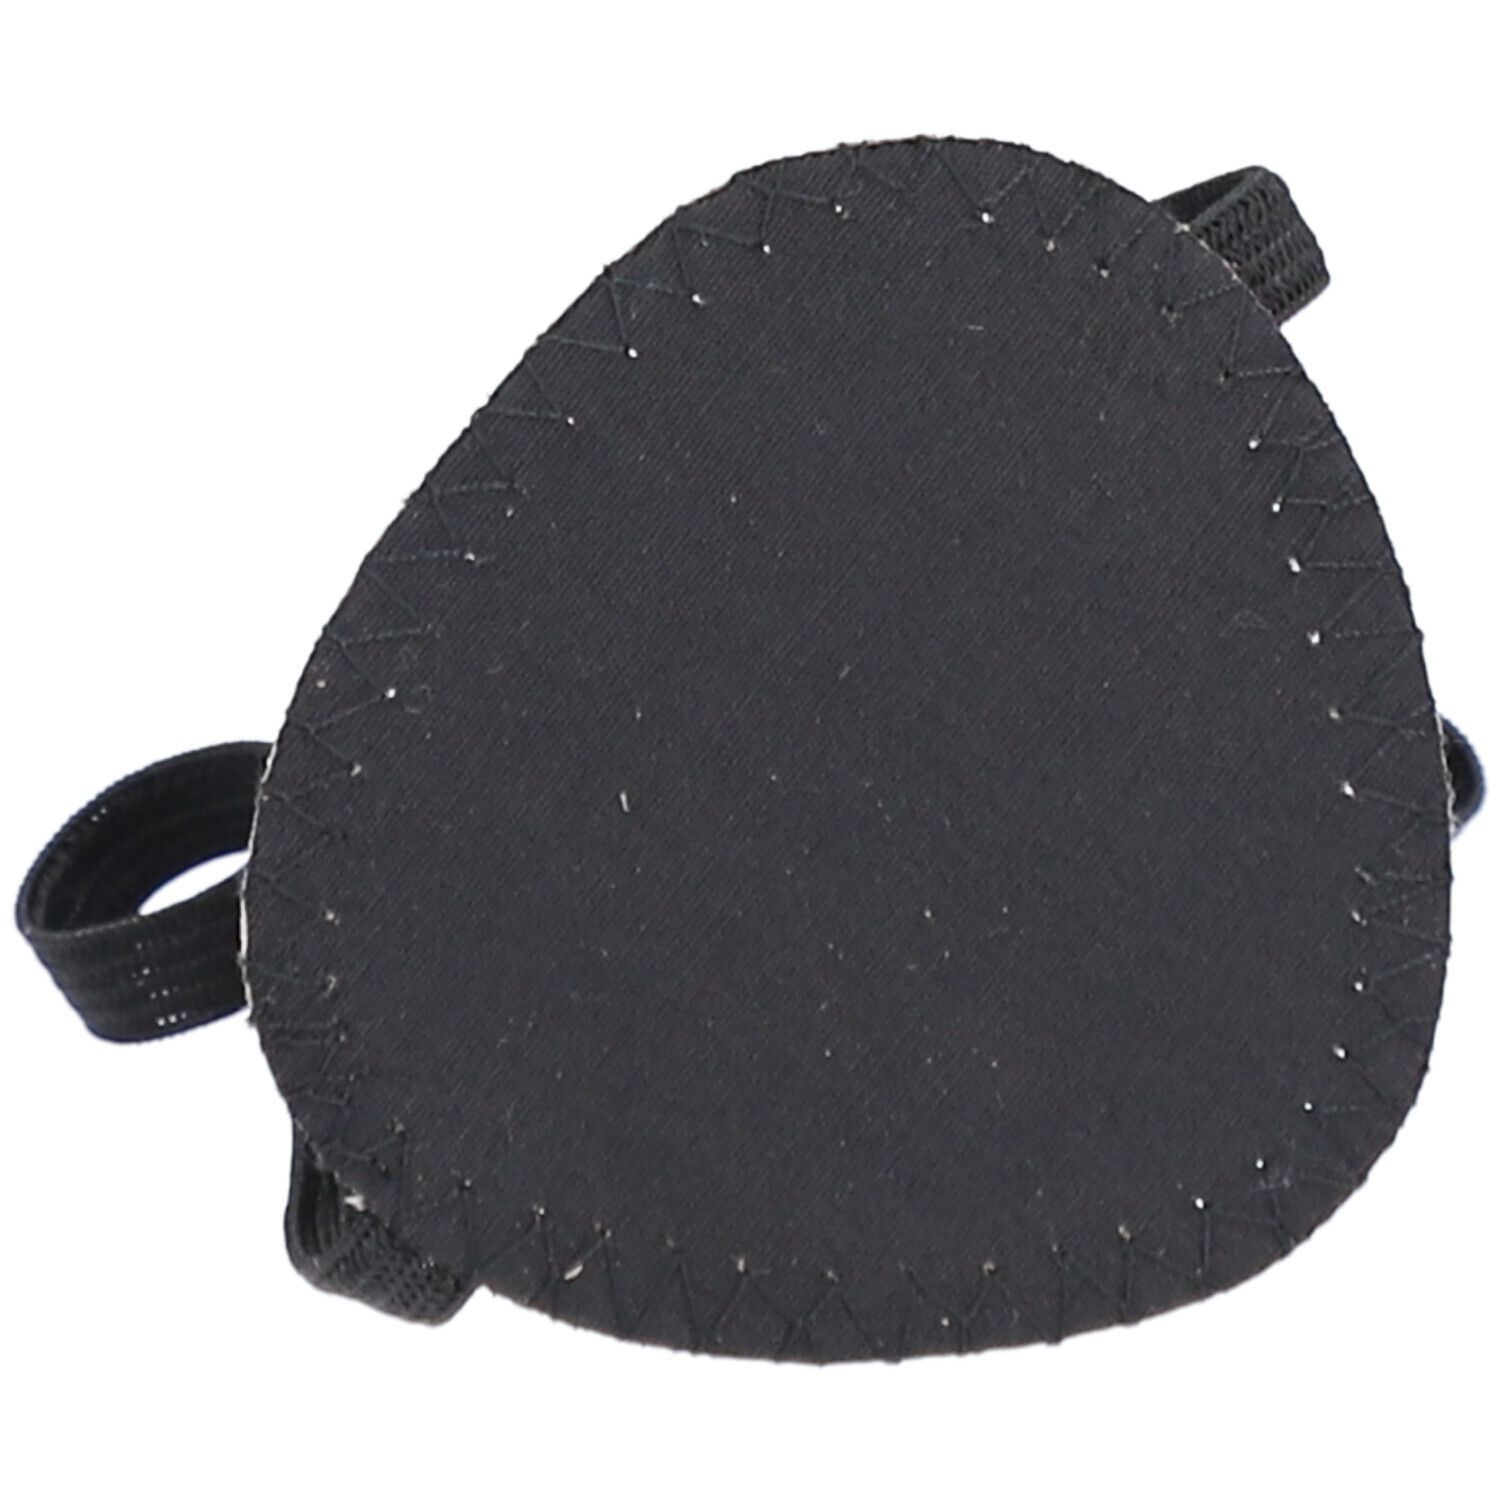
Augenklappe mit Gummiband sandfarben 5x 5x1 St VerbandSet enthält5x PARAM Augenklappe Sandfarben 1 StAugenklappe mit Gummiband, Sandfarben Die Augenbinde schützt Verbände am Auge vor Schmutz und hilft, Kompressen oder Verbände am Auge zu fixieren. Material: Pappe mit Stoffmantel, Band mit Gummizug.10,49 €*Versand: 3,99 €Sichere Weiterleitung zum Anbieter



-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **


Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Datenquellen
-
Augenklappe mit Gummiband sandfarben 5x 5x1 St VerbandSet enthält5x PARAM Augenklappe Sandfarben 1 StAugenklappe mit Gummiband, Sandfarben Die Augenbinde schützt Verbände am Auge vor Schmutz und hilft, Kompressen oder Verbände am Auge zu fixieren. Material: Pappe mit Stoffmantel, Band mit Gummizug.10,49 €*Versand: 3,99 €Sichere Weiterleitung zum Anbieter
-
Heyl, Vera: Pädagogik bei Blindheit und SehbehinderungPädagogik bei Blindheit und Sehbehinderung , This textbook provides a comprehensive introduction to education for blindness and visual impairment. It broadens the perspective beyond the school and includes the individual=s entire lifespan, from early childhood education to old age. In this way, it presents the main foundations of the discipline, the profession and all institutions involved in education for the blind and visually impaired in a handy, compact form. References to practical work are a consistent principle. A unique aspect of the book is the close connection it makes between the psychological and diagnostic foundations and specific educational measures in the different areas of work. , Linsen, Tönungen & Folien > Lichter & Leuchten , Erscheinungsjahr: 20201031, Produktform: Kartoniert, Titel der Reihe: Kompendium Behindertenpädagogik##, Autoren: Heyl, Vera~Lang, Markus, Seitenzahl/Blattzahl: 239, Abbildungen: 28 Abbildungen, 10 Tabellen, Themenüberschrift: EDUCATION / Special Education / General, Keyword: Behindertenhilfe; Diagnostik; Hilfsmittel, Fachschema: Bildung / Bildungsmanagement~Bildungsmanagement~Management / Bildungsmanagement~Bildungspolitik~Politik / Bildung~Behindertenpädagogik (Sonderpädagogik)~Behinderung / Pädagogik~Pädagogik / Behinderung~Pädagogik / Sonderpädagogik~Sonderpädagogik, Fachkategorie: Sonderpädagogik, Bildungszweck: für spezielle Lernschwächen, Warengruppe: HC/Sonderpädagogik, Behindertenpädagogik, Fachkategorie: Bildungsstrategien und -politik, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kohlhammer W., Verlag: Kohlhammer W., Verlag: Kohlhammer, W., GmbH, Länge: 231, Breite: 155, Höhe: 16, Gewicht: 368, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 240752632,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Trainingstherapie in der RehabilitationTrainingstherapie in der Rehabilitation , Konzepte, Therapie und Übungen , Scheibenpflege & Regenabweiser > Autopflege & Aufbereitung , Erscheinungsjahr: 20220726, Produktform: Kartoniert, Redaktion: Froböse, Ingo~Wilke, Christiane, Seitenzahl/Blattzahl: 564, Abbildungen: 346 farbige Abbildungen, 49 farbige Tabellen, Keyword: Physiotherapie; Rehabilitation; Orthopädie; Traumatologie; Sportwissenschaft; Trainingsmethoden; Trainingstherapie; Trainingswissenschaft; Sport; Bewegungstherapie; Aquatraining; Gangschulung, Fachschema: Medizin / Sportmedizin~Sportmedizin~Physikalische Therapie~Physiotherapie~Nachsorge (medizinisch)~Rehabilitation~Sport / Training~Training (körperlich), Fachkategorie: Physiotherapie~Rehabilitation~Sport: Training und Coaching, Bildungszweck: für die Berufsbildung~für die Hochschule~für berufsschulische und universitäre Bildung (Deutschland), Warengruppe: TB/Medizin/Allgemeines, Lexika, Fachkategorie: Sportmedizin, Sportverletzungen, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XX, Seitenanzahl: 564, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Urban & Fischer/Elsevier, Verlag: Urban & Fischer/Elsevier, Verlag: Urban & Fischer Verlag, Länge: 268, Breite: 211, Höhe: 25, Gewicht: 1532, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: SPANIEN (ES), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0008, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch, WolkenId: 277157764,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.